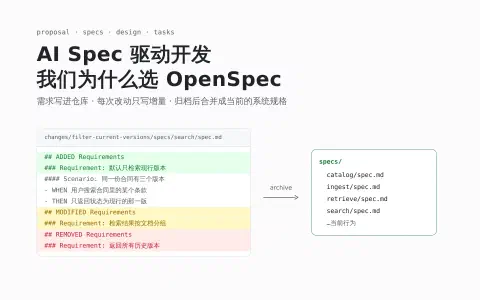
AI Spec 驱动开发:我们为什么选 OpenSpec
用 AI 写代码,需求只活在聊天记录里,换个会话就丢。Spec 驱动开发把需求写进仓库,但 Spec Kit、Kiro、Tessl 的做法差别很大,也有人批评它是瀑布流回潮。本文对比主流工具和业界的批评,说明我们为什么选了 OpenSpec,以及在十几个仓库、一百多次变更里形成的用法。
10 篇文章
用 AI 写代码,需求只活在聊天记录里,换个会话就丢。Spec 驱动开发把需求写进仓库,但 Spec Kit、Kiro、Tessl 的做法差别很大,也有人批评它是瀑布流回潮。本文对比主流工具和业界的批评,说明我们为什么选了 OpenSpec,以及在十几个仓库、一百多次变更里形成的用法。
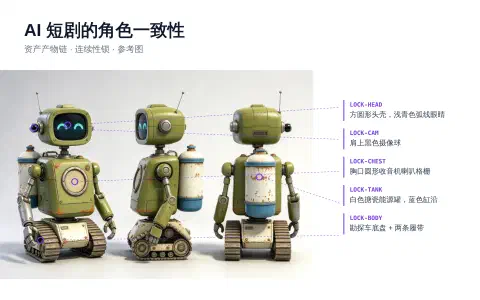
只用 API 做 AI 漫剧时,角色、道具和场景跨镜头保持一致靠的是参考图和固定文字。本文用一部原创动画的实测图说明:为什么源头图要先审,参考图和给人看的设定板要分开,连续性锁要原样复用,一个场景要按机位出一组空镜,以及怎样逐镜检查。
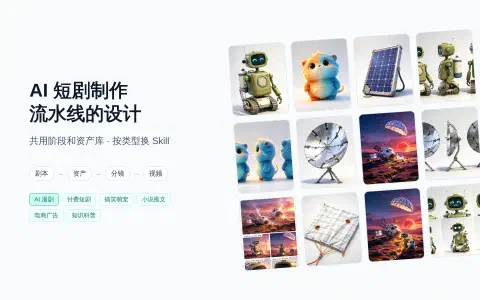
付费短剧、漫剧、小说推文、电商广告,节奏和检查规则各不相同。本文的做法是:剧本、资产、分镜、视频四个阶段和资产库所有类型共用,类型之间的差异写成一份 Skill,叠加到每个子 Agent 上。对比了开源短剧工具和多 Agent 论文的做法,附可翻页的交互演示。
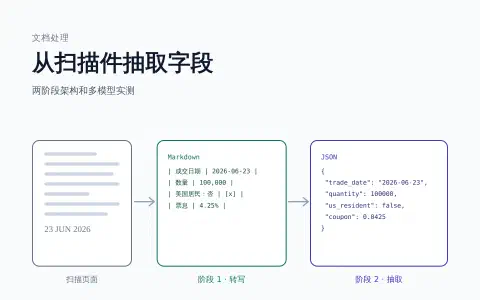
38 份扫描件、4,732 条字段断言:传统 OCR 路线达到 94.08% 的字段通过率,却只有 6 份文档全部通过。结合逐页转写、文本抽取和大 Schema 实验,讨论如何拆开识别与理解、保留原文证据,以及为什么双模型一致仍不等于正确。
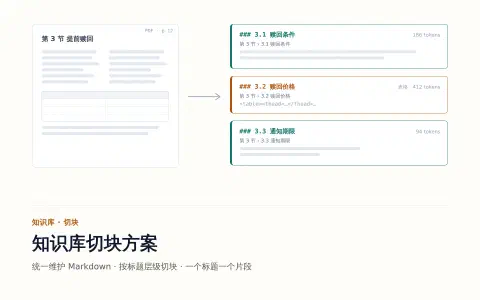
知识库维护的是一份 Markdown:PDF、网页、人工资料和问答都转成同一种约定,切块只读 Markdown 的标题树和块结构。本文介绍这套约定、PDF 的转写与校验、按标题层级切块的规则,并用检索评测说明为什么一个标题一个片段效果最好。
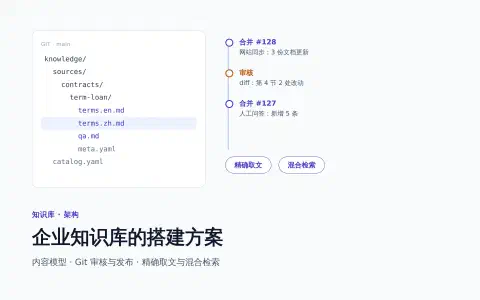
知识库像一座图书馆:分类、书和版本、目录、段落,一级一级缩小上下文,把准确的知识交给对话模型。本文结合一个约 1,800 份文档、中英双语的知识库项目,讨论如何先定义内容模型,用 Git 做审核和发布,让精确取文和混合检索并存,并用评测集而不是直觉来选择检索方式。
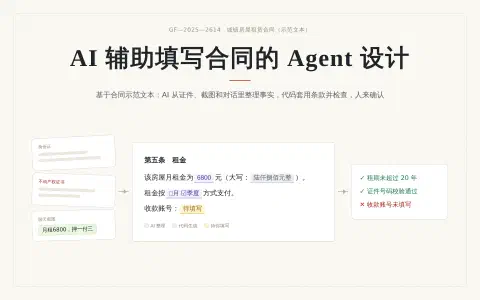
基于市场监管总局的合同示范文本:AI 从证件、截图和对话里整理事实并注明出处,代码套用条款、生成大写金额并逐条检查,人补齐空白、选定矛盾后生成合同。附可翻页的交互演示。
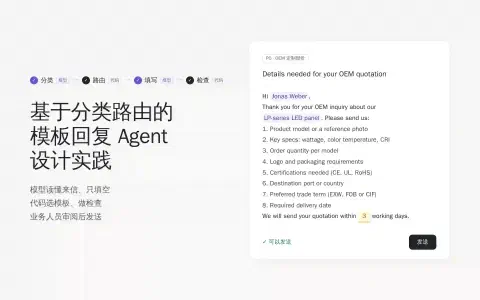
来信先分类,再按优先级路由到唯一的标准模板,模型只负责填空,代码负责检查,业务人员审阅后发送。以外贸询盘为例,附可翻页的交互演示。
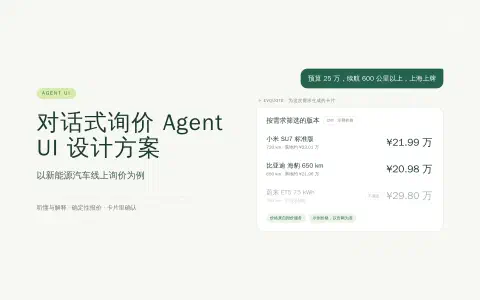
以新能源汽车线上询价为例:模型负责听懂和解释,报价和金融服务负责价格,卡片负责选择与确认。附可翻页的交互演示。
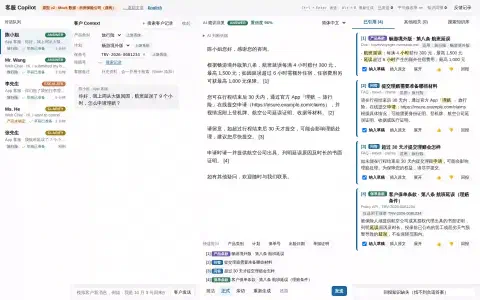
与其让 AI 直接回复客户,不如让它坐在客服旁边:起草、引用、澄清、护栏与反馈闭环——一个保险客服 Copilot 原型的设计记录,附可交互演示。